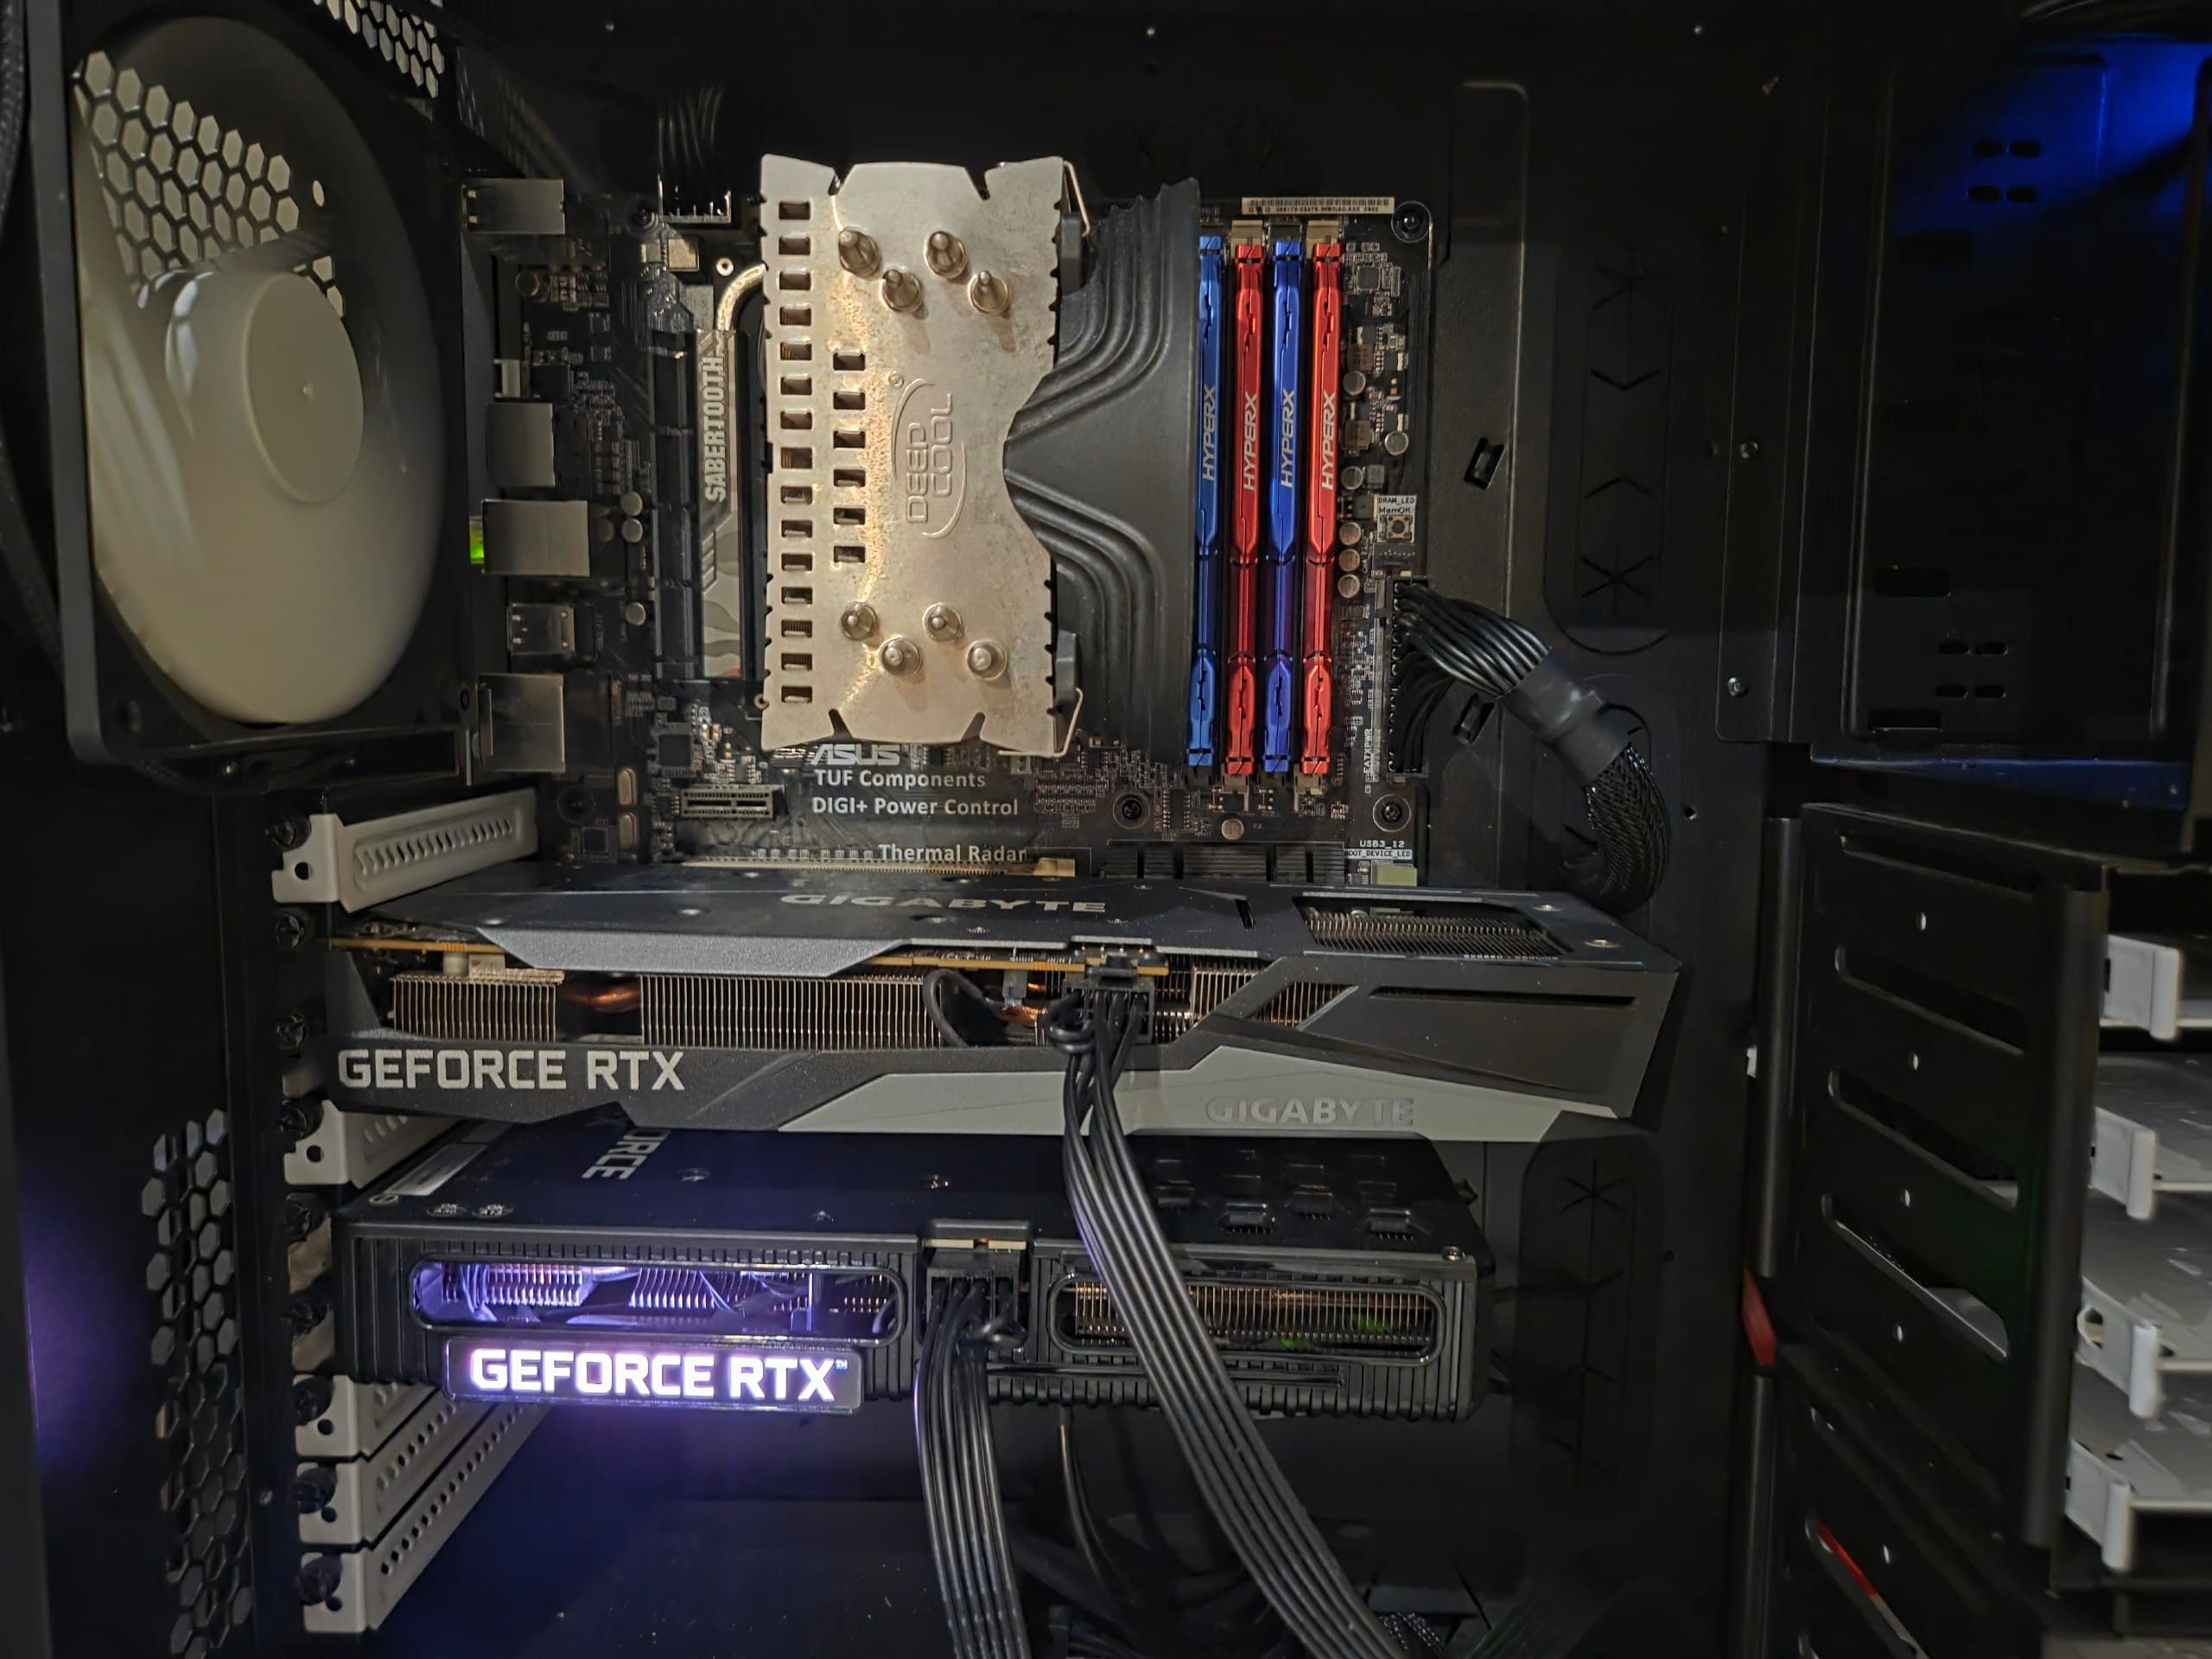
Можно ли превратить две RTX 3060 12 ГБ на старой Z97-платформе в нормальный локальный backend для OpenCode? Я начал с 9 токенов/с на длинном контексте и в итоге получил около 40 токенов/с в реальной агентной сессии с контекстом за 100K без ...
Можно ли превратить две RTX 3060 12 ГБ на старой Z97-платформе в нормальный локальный backend для OpenCode? Я начал с 9 токенов/с на длинном контексте и в итоге получил около 40 токенов/с в реальной агентной сессии с контекстом за 100K без уменьшения модели и без отказа от 128K.
В статье — tensor split без CUDA P2P, Q8 KV‑cache, встроенный MTP, подбор n-max, неудачные эксперименты с NCCL и shared buffers, реальные long‑context тесты и проверка качества на coding‑задачах.