Поле, примечание 009. Реплика опубликованного эталонного теста агентского цикла и того, что он скрывает. Каждый цикл агента должен решить, когда остановиться. Обычными опциями являются фиксированное max_iterations или разрешение агенту объявить себя выполненным. В июне я опубликовал...
Поле, примечание 009. Реплика опубликованного эталонного теста агентского цикла и того, что он скрывает.
Аннотация
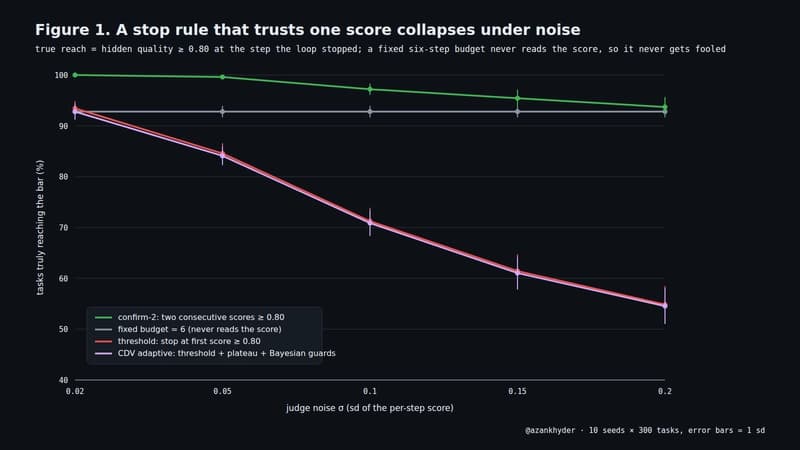
Каждый цикл агента должен решить, когда остановиться. Обычными опциями являются фиксированное max_iterations или разрешение агенту объявить себя выполненным. В июне я опубликовал небольшой тест с помощью CDV, эксперта с открытым исходным кодом для агентов кодирования, который показал, что байесовское правило адаптивной остановки использует на 41% меньше шагов, чем фиксированный бюджет из шести шагов, при этом достигая планки качества в 99,7% задач. Эта заметка повторяет этот результат в сегодняшнем коде (он воспроизводится до цифры), а затем расширяет его. Три вывода. (1) Адаптивная политика повсюду связывает простое пороговое правило («остановка при первой оценке ≥ 0,80»), и это происходит по конструкции: пороговая защита запускается первой в стеке защитных мер. (2) Оба рушатся, как только оценка судьи становится шумной. При уровне шума на шаг σ = 0,10 цикл считает, что достиг планки в 99,5% запусков, а на самом деле достиг ее в 71%. Фиксированный бюджет, равный шести, который никогда не учитывает оценку, удерживает 93% при каждом уровне шума. (3) Исправление в одну строку, требующее двух последовательных оценок выше шкалы, восстанавливает 97% истинного охвата при σ = 0,10 для 1,4 дополнительных шагов. Опубликованный заголовок был правдивым и не относился к делу: декабрь