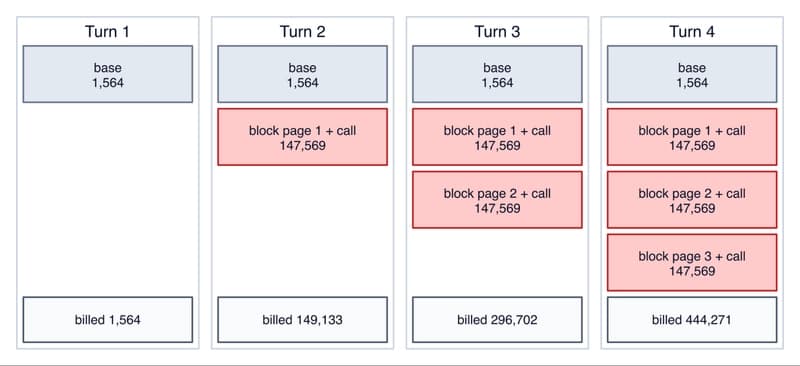
Счет LLM состоит из 2 частей: ставка и объем. Вы можете настроить оба. Но запрос по умолчанию почти не меняет ни одну из частей. Вы платите прейскурантную цену за повторяющийся контекст, за работу, которую никто не ждет, за простые вопросы, на которые могла бы ответить дешевая модель, и...
Счет LLM состоит из 2 частей: ставка и объем. Вы можете настроить оба. Но запрос по умолчанию почти не меняет ни одну из частей. Вы платите прейскурантную цену за повторяющийся контекст, за работу, которую никто не ждет, за простые вопросы, на которые могла бы ответить дешевая модель, и за звонки, которые ничего не возвращают. В отчете State of FinOps 2026 сообщается, что 98% команд управляют расходами на ИИ по сравнению с 31% два года назад, и в качестве основной задачи указывается прозрачность затрат на ИИ. Управление затратами не объясняет их. В этой статье показано, какие части этого счета являются необязательными и как прекратить их оплату.
ТЛ;ДР
В GPT-5.6 кэширование запросов снижает ставку для токенов префикса, которые вы повторно используете, а пакетная обработка снижает обе ставки вдвое. Кэширование происходит автоматически, если длина префикса превышает минимальную. Под ним вы не увидите ни скидки, ни ошибки. Пакетная обработка не обязательна, поэтому переместите сюда асинхронную работу.
Каскад из двух моделей экономит деньги до тех пор, пока 9 вызовов из 10 не перерастут, поэтому сначала отправьте дешевую модель, если разница в ставках составляет 10x, и вы сможете проверить ответ вместо того, чтобы доверять модели.
За неудавшуюся выборку счет пересчитывается при каждом последующем ходе. За 3 попытки необработанный HTML стоит в 136 раз дороже, чем извлеченный текст. Для 7 защищенных целей простой запрос вернул 0 пригодных для использования страниц, а один только IP-адрес лучшего качества вернул 3, с.