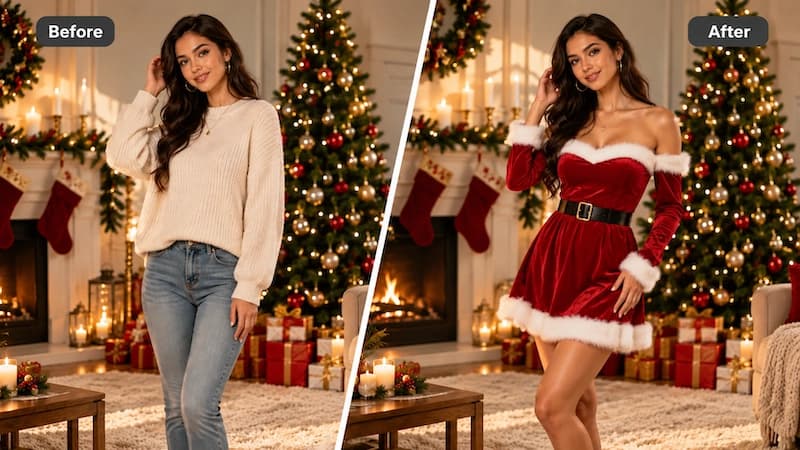
Виртуальная примерка снаружи выглядит обманчиво просто. Загрузите фотографию. Выберите наряд. Подождите несколько секунд. Получите новый образ. Именно этого ожидают пользователи. Но как только я начал более тесно работать с преобразованием одежды на основе изображений...
Виртуальная примерка снаружи выглядит обманчиво просто.
Загрузите фотографию. Выберите наряд. Подождите несколько секунд. Получите новый образ.
Именно этого ожидают пользователи.
Но как только я начал более тесно работать с преобразованием одежды на основе изображений, я понял, что самое интересное не в создании изображения. Самое сложное — сохранить достаточно информации из двух разных входных данных, чтобы сделать результат полезным.
Рабочий процесс виртуальной примерки должен понимать человека, одежду, положение тела, границы одежды, текстуру, цвет, освещение и окклюзию — и каким-то образом объединять их, не делая результат похожим на несвязанный портрет, созданный искусственным интеллектом.
Недавно я экспериментировал с этой проблемой, работая над небольшим примером использования в праздничной моде.
Вот некоторые вещи, которые я узнал.
Базовый рабочий процесс на самом деле представляет собой проблему двух изображений
Многие инструменты обработки изображений AI начинаются с одного изображения или одной подсказки.
Виртуальная примерка одежды – это другое.
Самая простая версия рабочего процесса выглядит примерно так:
Изображение человека
+
Справочник по одежде
↓
Выбор зоны одежды
↓
Трансформация изображения
↓
Сгенерированный предварительный просмотр
↓
Человеческое сравнение
Изображение человека сообщает системе, кому следует носить эту одежду.